


L’Intelligenza Artificiale (IA) generativa ha raggiunto capacità straordinarie nella creazione di testi e immagini, al tal punto da rendere difficile per un umano capire se un contenuto sia stato prodotto da un modello generativo. A conferma di ciò, nel nostro recente articolo abbiamo parlato di quanto ChatGPT sia vicino al superamento del test di Turing.
Per questo motivo la Learning Agency Lab ha lanciato su Kaggle, la piattaforma di competizioni online dedicata alla data science, una sfida entusiasmante (e con ricchi premi!): sei in grado di sviluppare un modello di IA in grado di determinare se un tema scolastico è stato scritto da un LLM (Large Language Model) o da uno studente? Questa competizione non solo sollecita le menti più brillanti nel campo del NLP, ma pone anche domande cruciali su quanto sia cambiato il mondo dell’educazione con l’avvento dei LLMs.

In questo articolo, esploreremo l’universo delle competizioni su Kaggle, analizzando l’importanza di questa sfida nel panorama attuale, discutendo le implicazioni che sorgono quando la linea tra il lavoro umano e quello generato da macchine diventa sempre più sottile.
Kaggle è una piattaforma online che ospita competizioni di data science, fornisce dataset e risorse per l’apprendimento automatico, e offre uno spazio in cui i professionisti del settore possono collaborare e condividere conoscenze. La piattaforma, fondata nel 2010, è diventata velocemente popolare tra ricercatori e professionisti del machine learning, tanto da essere acquisita da Google nel 2017.
Le competizioni su Kaggle abbracciano una vasta gamma di sfide, dalle previsioni più semplici a problemi di Computer Vision e persino a compiti complessi legati alla comprensione di aspetti biologici. Partecipare a queste competizioni permette agli utenti di affinare le proprie abilità nella data science e di confrontarsi con problemi del mondo reale.
Il dataset “Titanic – Machine Learning from Disaster” è uno dei più famosi e utilizzati sulla piattaforma e nella data science. Questo dataset contiene informazioni sui passeggeri a bordo del famoso RMS Titanic, il transatlantico che affondò durante il suo viaggio inaugurale nel 1912. L’obiettivo quando si lavora con questo dataset è predire se un passeggero è sopravvissuto o meno in base alle altre informazioni disponibili (genere, età, costo del biglietto). Questo dataset è spesso utilizzato per scopi educativi e dimostrativi in corsi e tutorial di data science. Kaggle ospita competizioni basate su questo dataset, incoraggiando la community a sviluppare modelli predittivi accurati.
Tra le competizioni più ricche e famose recentemente ospitate sulla piattarma troviamo:
“Puoi aiutare a costruire un modello per identificare quale tema è stato scritto da studenti delle scuole medie e superiori e quale è stato scritto utilizzando un LLM?”. Questo è il punto della sfida lanciata dalla Learning Agency Lab, un’organizzazione no-profit indipendente. L’organizzazione è impegnata nel mondo dell’istruzione, con attività riguardanti il miglioramento dei processi educativi, anche attraverso l’uso della tecnologia.
La Learning Agency Lab è attenta a quanto le tecnologie generative stiano cambiando il mondo dell’istruzione. Gli educatori sono preoccupati per l’impatto che questi strumenti possono avere sulle competenze sviluppate in età scolastica. Gli studenti hanno iniziato ad utilizzare i LLM per generare saggi che non sono di loro proprietà, perdendo importanti elementi chiave di apprendimento. La competizione nasce proprio da questa esigenza, il suo scopo è contribuire a identificare gli artefatti distintivi dei LLMs e far progredire lo stato dell’arte nella rilevazione del testo generato da IA. Il dataset comprende circa 10.000 saggi, alcuni scritti da studenti e altri generati da una varietà di LLMs. I testi a disposizione mirano a replicare scenari tipici di rilevamento, con lunghezze e argomenti simili a compiti reali.
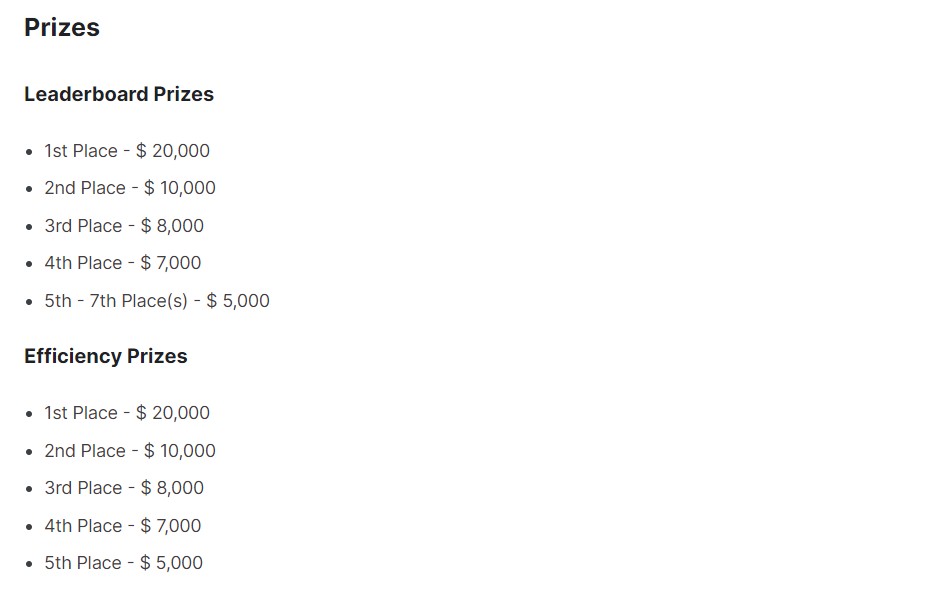
Grazie a una importante sponsorizzazione della Bill & Melinda Gates Foundation, la competizione assicura ricchi premi per le migliori soluzioni in termini di accuratezza ed efficienza (costo computazionale).
Le competizioni sono molto importanti nella community nel Machine Learning, sono spesso legate allo sviluppo di software open-source e permettono di sviluppare competenze tecniche. La competizioni lanciata da Learning Agency Lab conferma una attenzione sulla capacità di distinguere tra testi scritti da umani e generati da IA. Questo tipo di preoccupazione è trasversale su altri settori, come quello dell’informazione online e dei social-networks.

Sono ufficialmente aperte le adesioni al Program Sponsor della Red Hot Cyber Conference 2027, la sesta edizione dell’evento annuale gratuito promosso dalla community di Red Hot Cyber per diffondere cultura, competenze e consapevolezza sui temi della cybersecurity, dell’innovazione e delle tecnologie digitali. La Conference si terrà a Roma, martedì 18 e mercoledì 19 maggio 2027, presso l’Auditorium del Seraphicum, nel cuore del quartiere EUR, con una giornata dedicata ai workshop pratici e alle attività tecniche e una seconda giornata interamente dedicata alla conferenza.
Anche per il 2027, le aziende potranno scegliere di sostenere concretamente il progetto attraverso il Program Sponsor, partecipando alla crescita di un appuntamento che mette in relazione professionisti, aziende, istituzioni, studenti, ricercatori e appassionati di tecnologia. Il programma prevede la possibilità di aderire come Sponsor Sostenitore, una formula pensata per le aziende che desiderano essere tra le prime realtà a credere e contribuire alla realizzazione della nuova edizione, oppure attraverso i tre consueti livelli di sponsorizzazione Platinum, Gold e Silver. Ogni livello di sponsorizzazione acquistato, sarà accompagnato da un pacchetto Advertising, con l'opportunità di visibilità attraverso articoli, banner e contenuti all’interno del circuito editoriale di Red Hot Cyber.
Le aziende interessate a conoscere le formule disponibili, il Media Kit e tutte le opportunità previste dal Program Sponsor 2027 possono richiedere informazioni scrivendo a [email protected].